Wenn das Gerät selbst dazulernt: KI-Training direkt auf dem Mikrocontroller.
INSIGHTS
Warum die meisten Embedded-KI-Systeme nach dem Deployment einfrieren, was On-Device-Training daran ändert und wo die Grenzen heute wirklich liegen.
Verfasst von Philipp Knaack, MSc | CTO, Danube Dynamics
ca. 17 Minuten Lesezeit
Die öffentliche KI-Debatte dreht sich fast vollständig um eine Richtung:
immer größere Modelle, immer größere Rechenzentren, immer mehr Energie. Es gibt eine zweite Richtung, die genauso spannend ist und deutlich weniger Aufmerksamkeit bekommt, weil sie in die Gegenrichtung zeigt. Nicht hinauf in die Cloud, sondern hinunter auf den Mikrocontroller, direkt an den Sensor, dorthin, wo die Daten tatsächlich entstehen.
In Embedded-Systemen beschränkt sich der Einsatz von KI bislang überwiegend auf die Inferenz. Das Modell wird auf leistungsfähiger Hardware trainiert, für das Zielsystem optimiert und anschließend auf das Gerät übertragen. Dort führt es die erlernte Aufgabe aus. Das Training selbst findet außerhalb des Geräts statt.
Mit dem Deployment ist der Lernprozess damit zunächst abgeschlossen.
Die Welt rund um das Modell verändert sich jedoch weiter: Ein Werkstück kommt aus einer anderen Charge, eine Kamera altert oder eine Maschine verarbeitet eine neue Produktvariante. Soll das Modell auf solche Veränderungen reagieren, ist der übliche Prozess vergleichsweise aufwendig: Neue Daten werden am System gesammelt und übertragen, das KI-Modell wird auf leistungsfähiger Hardware erneut trainiert, anschließend optimiert und exportiert und schließlich als Update wieder auf das Gerät gespielt.
On-Device-Training verschiebt diese Frage.
Dieser Beitrag zeigt mit welchen Verfahren es heute trotzdem geht und wo die Grenzen liegen. Und er zeigt mit Edgeist ein Framework, das wir für genau dieses Problem mitentwickelt und jetzt als Open Source veröffentlicht haben. Einzelne Aspekte, etwa Quantisierung, Update-Management oder Datenpipeline, verdienen jeweils eine eigene Betrachtung und bekommen sie in weiteren Artikeln dieser Serie.
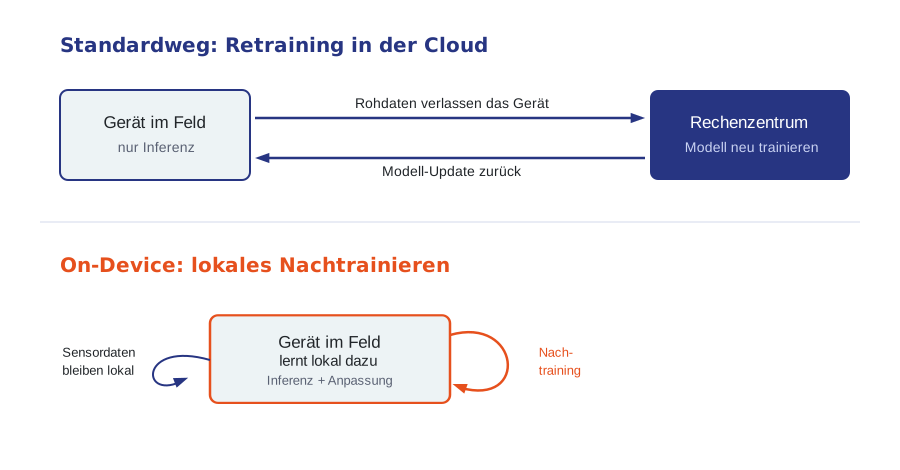
Abb.1: Zwei Wege, ein Modell im Feld aktuell zu halten. Oben der Standardweg über die Cloud: Daten verlassen das Gerät, das Modell wird zentral neu trainiert und als Update zurückgespielt. Unten die On-Device-Schleife: Anpassung passiert lokal, die Daten bleiben am Gerät.
Warum verliert ein Modell im Feld an Genauigkeit?
Ein KI-Modell trifft Entscheidungen anhand von Mustern, die es im Training gesehen hat. Was es nie gesehen hat, erkennt es nicht zuverlässig. Ein Industrieroboter, der auf eine feste Menge Werkstücke trainiert wurde, kann ein neues Bauteil nicht zuverlässig einordnen. Das ist kein Randfall, sondern der Normalfall über einen mehrjährigen Lebenszyklus. Die Ursachen sind bekannt und sammeln sich unter dem Begriff Data Drift:
Neue Klassen
Ein Objekt, eine Variante, ein Fehlerbild, das im Trainingsdatensatz schlicht nicht vorkam.
Sensor- und Umgebungsdrift
Bauteile altern, Beleuchtung, Temperatur und Verschmutzung verschieben die Eingangsverteilung langsam weg vom Trainingszustand.
Standortspezifik
Dasselbe Gerätemodell steht bei zehn Kunden unter zehn leicht unterschiedlichen Bedingungen, ein einziges globales Modell ist für keinen davon optimal.
Genau hier setzt die Forschung am Josef Ressel Zentrum für Embedded AI in Hagenberg an, an der wir als Unternehmenspartner beteiligt sind. Die Leitidee: Statt für jedes neue Muster ein Modell zentral neu zu trainieren und zu verteilen, soll das Gerät den Anpassungsprozess selbst starten können, während es arbeitet.
Der Standardweg und seine Kosten.
Der heute übliche Weg ein Feldmodell aktuell zu halten, läuft über die Cloud. Neue Trainingsdaten werden aufgezeichnet und übertragen, ein Rechenzentrum trainiert das Modell neu und das Ergebnis wird über das Internet zurück auf das Gerät gespielt. Technisch funktioniert das, aber es hat vier strukturelle Kosten, die im industriellen Umfeld schwer wiegen:
1. Konnektivität
Viele Geräte stehen in Produktionshallen ohne verlässliche Internetverbindung, hinter Firewalls oder in abgeschotteten Netzen. Ein Prozess, der eine dauerhafte Cloud-Anbindung voraussetzt, ist dort keine Option.
2. Datenhoheit
Sensordaten aus der Fertigung sind sensibel. Sobald sie das Gerät verlassen, entsteht ein Vertraulichkeits- und Compliance-Thema. Bleiben sie lokal, entfällt es.
3. Energie
Ein Cloud-Training samt Datentransfer verbraucht ein Vielfaches dessen, was ein Mikrocontroller braucht. Die Anpassung dort auszuführen, wo die Daten anfallen, spart Übertragung und Rechenzentrumslast.
4. Autonomie und Reaktionszeit
Ein Rechenzentrum kann ein Modell in der Regel deutlich schneller trainieren als ein Mikrocontroller. Zum klassischen Trainingsprozess kommt jedoch die Zeit für die Übertragung der (oft umfangreichen) Trainingsdaten hinzu. Anschließend muss das aktualisierte Modell wieder auf das Gerät übertragen und dort eingespielt werden. Lokales Nachtraining kann diesen Gesamtprozess verkürzen und ermöglicht es dem Gerät, sich ohne Datenübertragung an veränderte Bedingungen anzupassen.
Die Konsequenz aus diesen Punkten ist keine graduelle Optimierung, sondern eine andere Architektur: Der Trainingsschritt wandert auf das Gerät.
Warum Training auf dem Mikrocontroller schwierig ist.
An dieser Stelle wird klar, warum On-Device-Training bisher die Ausnahme ist. Inferenz und Training sind auf einem Mikrocontroller nicht dasselbe Problem in zwei Größen, sondern zwei verschiedene Probleme.
Inferenz gegen Training: woher der Aufwand kommt
Inferenz ist ein reiner Vorwärtsdurchlauf: Eingabe rein, Schicht für Schicht durchrechnen, Ergebnis raus. Zwischenergebnisse können danach wieder verworfen werden.
Beim Training über Backpropagation ist das anders:
- Die Zwischenergebnisse des Vorwärtsdurchlaufs müssen für die anschließende Rückwärtsberechnung im Speicher gehalten werden, beim Batch-Training sogar für mehrere Durchläufe gleichzeitig.
- Danach werden die Gradienten rückwärts durch das Netz berechnet und schließlich die Gewichte angepasst.
Vor allem der Speicherbedarf für die Aktivierungen und die zusätzliche Rückwärtsberechnung machen das Training deutlich aufwendiger als reine Inferenz.
Das Speicherbudget eines Mikrocontrollers
Das kollidiert frontal mit der Realität eines Mikrocontrollers. Wir reden hier über Kilobyte bis wenige Megabyte RAM, nicht über die Gigabyte einer GPU. Zwischen dem verfügbaren Speicher eines typischen Mikrocontrollers und einer GPU liegen vier bis fünf Größenordnungen.
Die Standard-Runtimes trainieren nicht
Erschwerend kommt hinzu, dass die etablierten Embedded-Runtimes genau diesen Schritt nicht können: Klassisches TensorFlow Lite beziehungsweise dessen Nachfolger für Mikrocontroller und die mobilen Standard-Runtimes sind für Inferenz ausgelegt, nicht für das Training am Gerät. Wer auf dem MCU trainieren will, kann also nicht einfach den Trainingscode vom Entwicklungsrechner mitnehmen. Er braucht einen anderen Ansatz.
Die Techniken, die On-Device-Training möglich machen.
Die Lösung besteht nicht darin, mehr Speicher zu finden, sondern weniger davon zu brauchen. Statt das komplette Netz vollständig zu trainieren, wird gezielt nur der Teil angepasst, der für die neue Situation zählt. Vier Ansätze haben sich herausgebildet, mit klar unterschiedlichen Trade-offs.
| Ansatz | Was wird angepasst | Speicher-Hebel | Grenze / Trade-off |
|---|---|---|---|
| Last-Layer (z. B. TinyOL) | nur die letzte Schicht | sehr klein, online möglich | begrenzte Anpassungstiefe |
| Bias-only (z. B. TinyTL) | Bias/kleine Komponenten, Gewichte eingefroren | senkt den Aktivierungsspeicher gezielt | weniger Kapazität als volles Training |
| Sparse Update (Tiny Training Engine) | ausgewählte, wichtige Schichten und Kanäle | Training in unter 256 KB möglich | Compile-Zeit-Aufwand, v. a. für CNNs |
| Full Backprop (z. B. mit AIfES) | das gesamte Netz | trainiert CNNs ab gut 100 KB RAM | am rechen- und speicherintensivsten |
Vergleich verschiedener Ansätze für On-Device-Training hinsichtlich Anpassungstiefe, Speicherbedarf und Trade-offs.
Wie weit sich das treiben lässt, zeigt eine viel beachtete Arbeit aus dem MIT-Umfeld:
Dort wurde gezeigt, dass sich ein Modell in unter 256 KB Speicher am Gerät trainieren lässt, mit weniger als einem Tausendstel des Speichers, den ein PyTorch-Training benötigt, und bei vergleichbarer Genauigkeit. Der Trick ist kein einzelner Kniff, sondern ein Zusammenspiel: eine quantisierungsbewusste Skalierung der Gradienten, damit das Training im Ganzzahlformat stabil bleibt, und ein sparsames Update, das die Rückrechnung nur für die wirklich relevanten Teile des Netzes ausführt. Ein Teil dieser Arbeit wandert dabei bewusst von der Laufzeit in die Compile-Zeit, wo der Speicher noch nicht knapp ist.
Der ehrliche Rahmen dazu: On-Device-Training ersetzt kein Rechenzentrum.
Ein Modell komplett von null auf einem MCU zu trainieren, ist für die meisten Aufgaben weder nötig noch sinnvoll. Der realistische und wertvolle Fall ist das Nachtrainieren bzw. das (Fine-)Tuning: ein solide vortrainiertes Modell, das sich am Gerät an neue Klassen, an Drift und an den konkreten Standort anpasst. Dafür ist die Technik heute reif genug, für alles darüber hinaus muss man von Fall zu Fall rechnen.
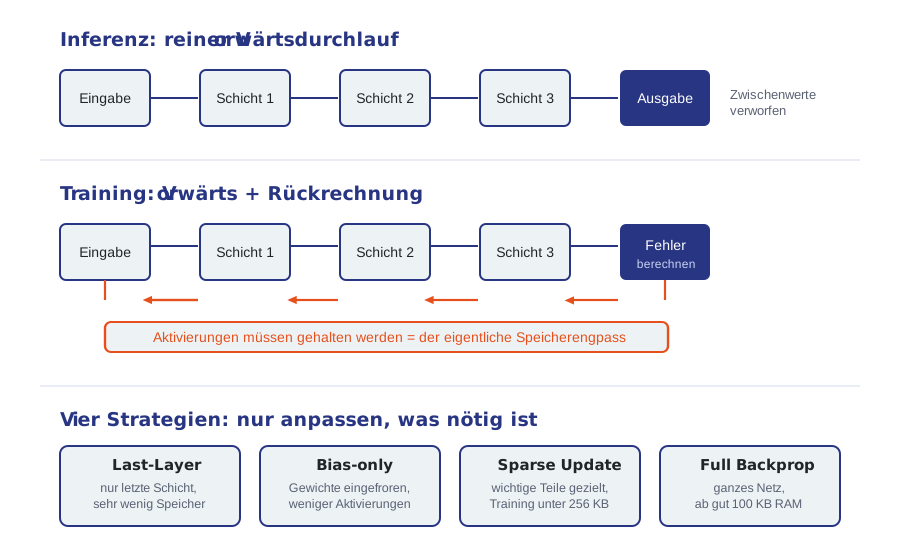
Abb. 2: Inferenz ist ein reiner Vorwärtsdurchlauf, Zwischenergebnisse können verworfen werden. Training muss den Fehler zurückrechnen und dafür die Aktivierungen halten. Die vier Update-Strategien reduzieren genau diesen Speicherbedarf, mit unterschiedlicher Anpassungstiefe.
Das Werkzeug-Ökosystem.
On-Device-Training auf Mikrocontrollern ist kein rein akademisches Thema mehr.
Die Werkzeuglandschaft ist allerdings noch klein und deutlich spezialisierter als bei der Inferenz.
ist ein in C entwickeltes Framework, das Inferenz und Training direkt auf Mikrocontrollern ermöglicht. Bei CNNs benötigt es laut Fraunhofer bis zu 54 Prozent weniger Speicher als die TensorFlow-Lite-Micro-Referenz; kompakte Netze lassen sich bereits mit etwas mehr als 100 kB RAM trainieren.
verfolgt einen ähnlichen Ansatz für RISC-V-Multicore-Mikrocontroller. Die Open-Source-Bibliothek stellt optimierte Trainingsoperationen für Forward- und Backpropagation bereit und nutzt unter anderem Parallelisierung und Speicheroptimierung, um das Training auf stark ressourcenbeschränkter Hardware zu ermöglichen.
Bei den etablierten KI-Runtimes zeigt sich dagegen noch eine klare Grenze: LiteRT for Microcontrollers ist auf Inferenz ausgelegt und unterstützt aktuell kein On-Device-Training. ONNX Runtime bietet zwar On-Device-Training, zielt damit aber auf leistungsfähigere Plattformen wie Linux, Windows, Android und iOS und nicht auf klassische Bare-Metal-Mikrocontroller ab.
Die Werkzeugwahl hängt letztlich von Zielhardware, Modellarchitektur und verfügbarem Speicher ab.
Einen universellen Trainings-Stack für Mikrocontroller gibt es bislang nicht. On-Device-Training erfordert weiterhin eine deutlich stärkere Anpassung an die konkrete Hardware als reine Inferenz.
Edgeist: unser Beitrag aus dem Josef Ressel Zentrum.
In genau dieses Feld fällt Edgeist, ein Framework für das Trainieren und Nachtrainieren von Machine-Learning-Modellen direkt auf ressourcenbeschränkten Geräten, das im Josef Ressel Zentrum für Embedded AI gemeinsam mit uns entstanden ist und jetzt in einer ersten Open-Source-Version vorliegt. Der Kern ist bewusst dort angesetzt, wo es am schwersten ist: On-Device-Training für Mikrocontroller, also für sehr kleine Systeme mit wenig Rechenleistung und Speicher. Die Umsetzung ist auf C/C++ ausgelegt und bringt reproduzierbare Beispiele für Training und Inferenz mit.
Warum quelloffen?
Weil ein Werkzeug in diesem frühen, forschungsnahen Feld mehr bewegt, wenn andere es einsetzen und weiterentwickeln können: Forschende, Studierende, Entwickler und Industriepartner. Ein kostenpflichtiges Nischenprodukt bliebe in der Praxis weitgehend ungenutzt, ein offenes Fundament erreicht eine breite Community und trägt zur Weiterentwicklung bei. Das ist dieselbe Haltung, mit der wir auch sonst arbeiten: Das Fundament gehört geteilt, der Wert entsteht in der konkreten Anwendung.
Der Rahmen dahinter ist eine echte Forschungsstruktur. Das Josef Ressel Zentrum für Embedded AI wurde im Mai 2024 am Campus Hagenberg der FH Oberösterreich eröffnet, angesiedelt im Embedded Systems Lab und geleitet von FH-Prof. DI (FH) Dr. Florian Eibensteiner. Geforscht wird gemeinsam mit zwei Industriepartnern, Fronius International und uns, unter dem Dach der Christian Doppler Forschungsgesellschaft und mit rund 600.000 Euro Förderung über fünf Jahre, ergänzt durch einen engen Austausch mit dem Christian Doppler Labor für Embedded Machine Learning an der TU Wien. Wir sind an diesem Zentrum nicht nur als Anwender beteiligt, sondern finanzieren einen Teil davon mit.
Für uns ist das die Konsequenz aus einer einfachen Überzeugung:
Wer serienreife Embedded-KI bauen will, muss an der vordersten Front mitforschen, nicht nur zusehen.
Edgeist (Open Source)
Framework für das Trainieren und Nachtrainieren von ML-Modellen direkt auf ressourcenbeschränkten Geräten.
Eignet sich für:
- On-Device-Training und Nachtraining von ML-Modellen
- Edge-AI-Workflows für ressourcenbeschränkte Hardware
- Adaptives Deep Learning auf Embedded-Systemen
- Reproduzierbare Beispiele für Training und Inferenz
Basis: C/C++
Lizenz: MIT
Repository: https://github.com/fhooe/Edgeist
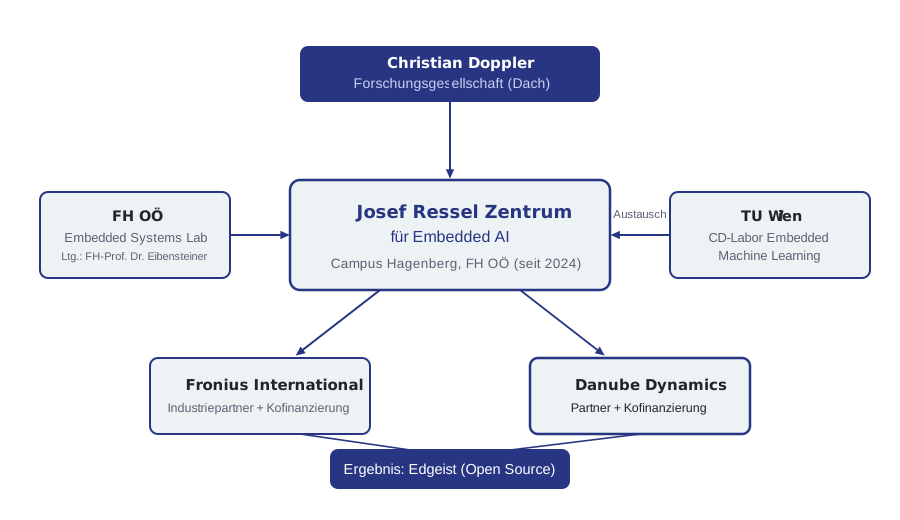
Abb. 3: Die Forschungskonstellation hinter Edgeist. Das Josef Ressel Zentrum am Campus Hagenberg bündelt FH-OÖ-Forschung und zwei Industriepartner unter dem Dach der Christian Doppler Forschungsgesellschaft, mit Austausch zur TU Wien.
Forschungsziel:
Lernen direkt an der Maschine.
Anders als in unseren Serienprojekten, in denen wir mit ausgelieferten Ergebnissen argumentieren, ist On-Device-Training ein forschungsnahes Feld. Unser Schwerpunkt im Josef Ressel Zentrum liegt derzeit auf Zeitreihendaten, also auf den kontinuierlichen Sensor- und Messsignalen, die Geräte und Maschinen im Betrieb erzeugen. Das folgende Szenario ist deshalb kein abgeschlossenes Kundenprojekt, sondern zeigt die Richtung, in die diese Arbeit zielt.
Die Forschungsfrage:
Wie kann ein einzelnes Gerät ein Modell für solche Signale am Einsatzort nachtrainieren, sodass es sich an genau die Maschine und deren Betriebsbedingungen anpasst, statt mit einem globalen Durchschnittsmodell zu arbeiten?
Ein typisches Bild dafür ist die Zustandsüberwachung. Ein Gerät lernt das normale Signalverhalten genau der Maschine, an der es sitzt, und erkennt Abweichungen zuverlässiger, weil das Modell nicht auf den Durchschnitt vieler Maschinen, sondern auf diese eine kalibriert ist.
Der praktische Hebel ist Autonomie:
Die Anpassung passiert lokal, ohne dass die Rohdaten das Gerät verlassen, und ohne dass für jede neue Maschine ein zentraler Trainingslauf nötig ist. Dass sich das im Speicher- und Rechenbudget eines eingebetteten Systems überhaupt abbilden lässt, zeigen die oben beschriebenen Verfahren, die Training in den Bereich von Hunderten Kilobyte bringen.

Fazit: der Reiz liegt in der Grenze.
„On-Device-Training ersetzt kein Rechenzentrum. Sein Wert liegt darin, dass sich ein Modell am Gerät an genau seine Maschine anpasst, statt zum Auslieferungszeitpunkt einzufrieren."
Philipp Knaack, MSc | CTO, Danube Dynamics
Die wesentlichen Grenzen liegen in Speicher und Rechenleistung der Zielhardware und wer sie ignoriert, baut eine Demo, die im Feld nicht trägt.
Der spannende Bereich ist das Nachtrainieren am Gerät: ein vortrainiertes Modell, das sich an neue Klassen, an Drift und an den konkreten Standort anpasst, lokal, energiesparend und ohne die Daten aus der Hand zugeben.
Dass sich dieses Feld gerade rasant bewegt, ist der eigentliche Punkt. Es zeigt, dass sinnvolle KI nicht zwangsläufig ins Rechenzentrum wandert, sondern näher an die Maschine rücken kann, dorthin, wo die Entscheidung fällt. Mit Edgeist und der Arbeit im Josef Ressel Zentrum tragen wir ein Stück dazu bei, und weil das Fundament offen ist, kann jeder darauf aufbauen.
Sie haben ein konkretes Projektvorhaben?
Dann sprechen Sie am besten direkt mit denen, die solche Systeme täglich bauen. Buchen Sie einen kostenlosen Ersttermin und erhalten Sie eine erste Einschätzung zu Ihrem Projektvorhaben, inklusive technischer Machbarkeit und einer ersten
Kostenindikation.
Die häufigsten Fragen zu On-Device-Training:
In den seltensten Fällen und meist wäre es auch nicht sinnvoll. Der realistische Anwendungsfall ist das Nachtrainieren: Ein Modell wird wie gewohnt auf leistungsstarker Hardware vortrainiert, und nur die Anpassung an neue Klassen, an Drift oder an den konkreten Standort passiert am Gerät. Ein vollständiges Training von null ist auf einem MCU technisch möglich, aber für die meisten Aufgaben der falsche Weg. Die richtige Frage ist nicht ob Training am Gerät möglich ist, sondern welcher Teil des Trainings dorthin gehört.
In der Regel der Speicher, genauer der Arbeitsspeicher für die Aktivierungen. Inferenz kann Zwischenergebnisse nach jeder Schicht verwerfen, Training über Backpropagation muss sie halten, um den Fehler zurückzurechnen. Deshalb setzen die tragfähigen Verfahren genau dort an und trainieren nur ausgewählte Teile des Netzes. Die Rechenzeit ist auf modernen MCUs oft das kleinere Problem als das Speicherbudget, je nach Anwendungsfall aber durchaus relevant.
Weil sie für Inferenz gebaut sind, nicht für Training. Die mobilen und eingebetteten Standard-Runtimes führen Modelle aus, sie trainieren sie nicht. Für On-Device-Training braucht es Werkzeuge, die den Rückwärtspfad speichereffizient umsetzen, etwa AIfES, PULP-TrainLib oder forschungsnahe Bibliotheken wie das aus dem Josef Ressel Zentrum entstandene Edgeist.
Das ist einer der stärksten Gründe für den Ansatz. Beim On-Device-Training verlassen die Trainingsdaten das Gerät nicht, die Anpassung passiert lokal. Gerade in der Fertigung, wo Sensordaten sensibel sind und Hallen oft ohne durchgehende Cloud-Anbindung laufen, ist das ein handfester Vorteil, kein Nebeneffekt. Die strategische Seite davon, digitale Souveränität für Europas Geräte- und Maschinenbau, hat unser CEO Nico Teringl rund um den eDay 2026 beschrieben.
Für das Nachtrainieren eines vortrainierten Modells am Gerät ist die Technik serienreif und für konkrete Aufgaben einsetzbar. Die reale Einschränkung liegt woanders: Noch nicht alle Operationen und Modellarchitekturen werden am Gerät unterstützt. Wer den Einsatz erwägt, sollte deshalb mit einer klar umrissenen Aufgabe und einer ehrlichen Machbarkeitsbewertung starten, statt mit dem größten denkbaren Ziel.
Über den Autor.
Philipp Knaack, MSc
CTO I Danube Dynamics
Philipp Knaack verantwortet als CTO die technische Ausrichtung von Danube Dynamics, von Embedded-Linux-Architektur über Serienintegration bis zu Embedded KI. Er vertritt das Unternehmen im Josef Ressel Zentrum für Embedded AI in Hagenberg und denkt Technologieentscheidungen konsequent vom realen Feldeinsatz und von den Trade-offs her, nicht vom Datenblatt. Sein Fokus liegt auf Systemen, die nicht nur im Prototyp, sondern über Jahre im Feld tragen.